Crawl là quá trình bot của công cụ tìm kiếm truy cập một URL, tải nội dung trang về và đọc các liên kết trong đó để tìm tiếp trang mới. Với Google, việc này do Googlebot làm, và một trang phải được crawl thì Google mới có thể lập chỉ mục rồi đưa lên kết quả tìm kiếm. Điều nhiều hướng dẫn bỏ qua là phần lớn website nhỏ không hề thiếu ngân sách crawl. Theo chính tài liệu của Google, chỉ site hàng chục nghìn trang thay đổi hằng ngày mới cần tối ưu crawl budget, còn site vài trăm trang thường gặp vấn đề ở chất lượng nội dung hoặc cấu hình chặn nhầm.
Crawler là gì và vì sao gọi là crawl?
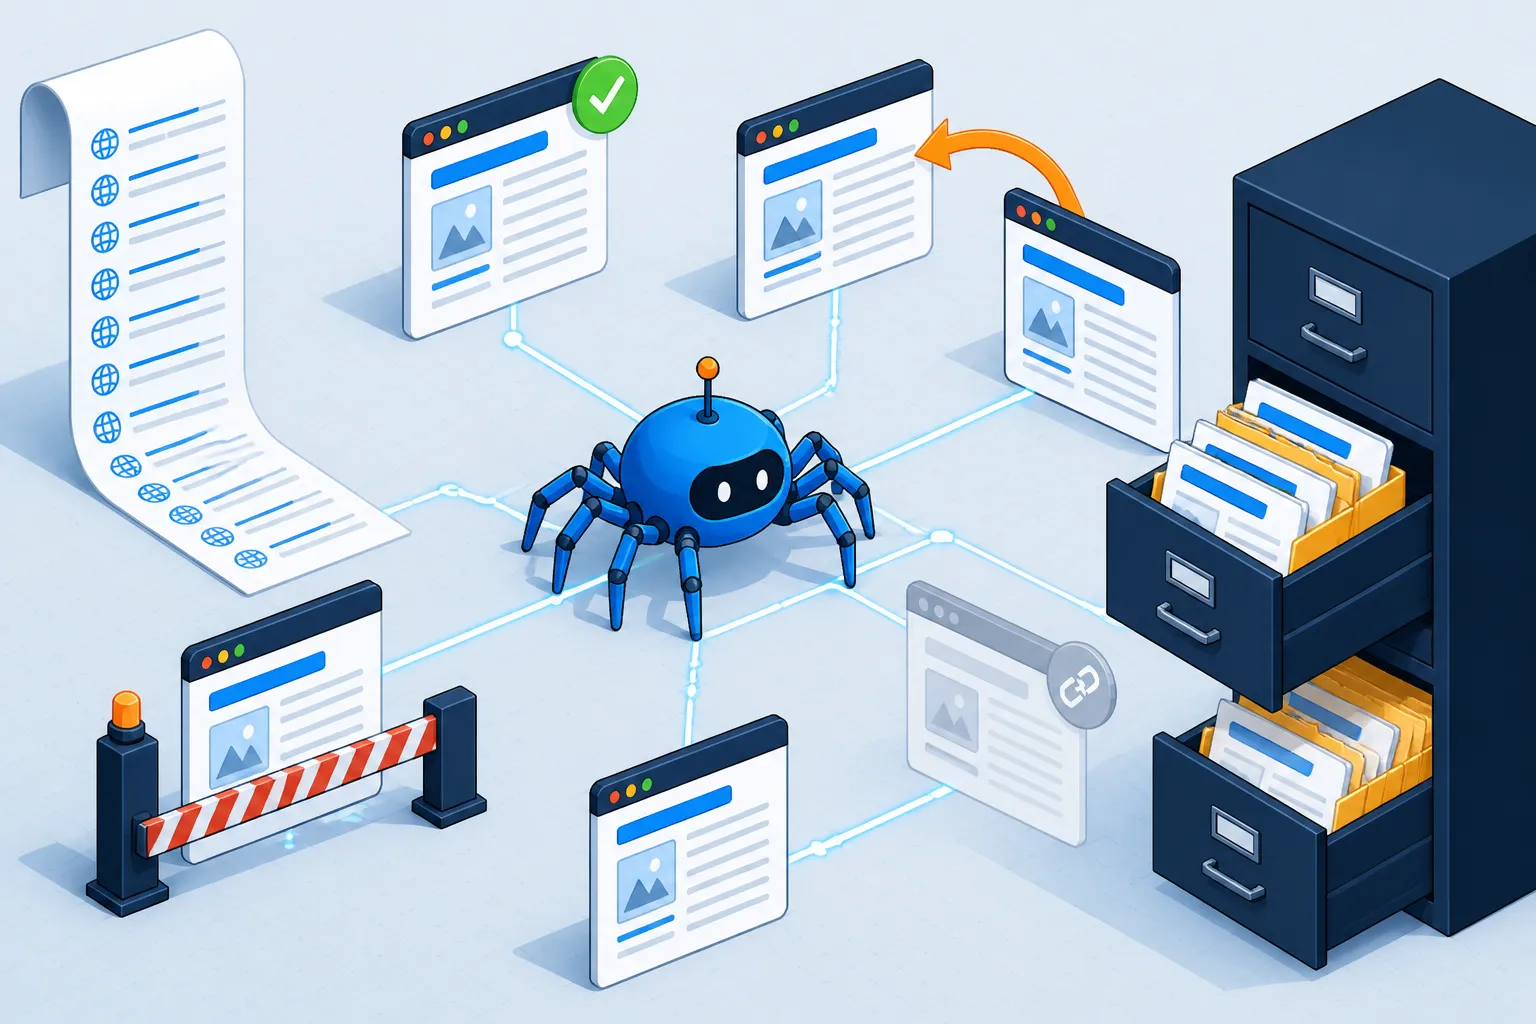
Crawl trong tiếng Anh nghĩa gốc là bò hoặc trườn, và trong SEO từ này chỉ hành động của bot đi chậm qua từng trang theo các đường liên kết, giống một con nhện bò trên mạng lưới, nên bot còn được gọi là spider. Chương trình làm việc đó gọi là crawler. Mỗi công cụ tìm kiếm có crawler riêng, như Googlebot của Google hay Bingbot của Bing, và gần đây có thêm crawler của các công ty AI như GPTBot hay ClaudeBot. Google mô tả Googlebot là chương trình tự động quyết định crawl site nào, bao lâu một lần và bao nhiêu trang mỗi site, dựa trên thuật toán chứ không theo yêu cầu của chủ website. Google cũng nói rõ họ không nhận tiền để crawl một site thường xuyên hơn. Với phần lớn website, Googlebot chỉ ghé trung bình không quá một lần mỗi vài giây, nên nếu thấy bot gọi dồn dập hơn thế, có thể đó là bot giả mạo tên Googlebot.
Googlebot crawl một trang như thế nào?
Googlebot đi qua năm bước, trong đó bốn bước đầu là crawl và bước cuối đã thuộc về lập chỉ mục:
- Khám phá URL. Google biết đến một URL qua link từ trang đã crawl trước đó, qua sitemap.xml bạn khai báo, hoặc từ danh sách URL đã crawl ở các lần trước.
- Đọc robots.txt. Trước khi tải trang, bot kiểm tra file robots.txt của tên miền. URL bị
Disallowsẽ không được tải. - Tải trang. Googlebot, chủ yếu là bản Smartphone, tải HTML và các tài nguyên như CSS, JavaScript. Google hiện chỉ đọc 2MB đầu của mỗi file HTML, phần sau bị bỏ qua.
- Render. Google chạy trang bằng một bản Chrome gần mới nhất để thấy nội dung do JavaScript tạo ra, đồng thời lấy thêm link để crawl tiếp.
- Lập chỉ mục. Google phân tích nội dung, chọn một URL canonical trong nhóm trang trùng nhau và quyết định có lưu trang hay không.
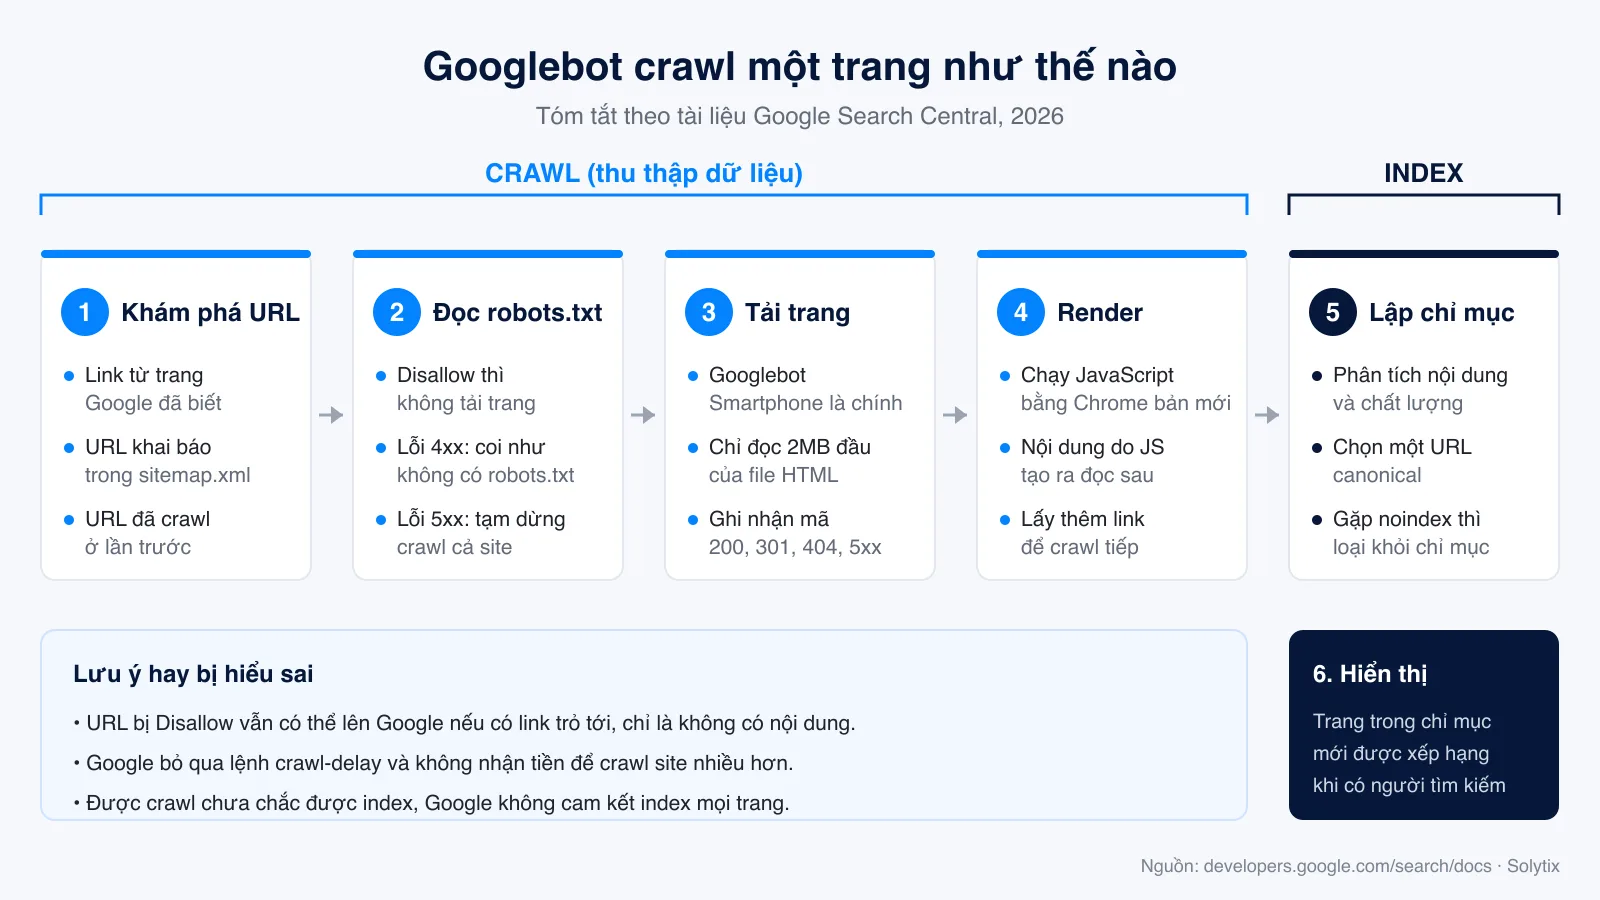 Sơ đồ năm bước Googlebot xử lý một trang, từ khám phá URL, đọc robots.txt, tải trang, render tới lập chỉ mục, kèm ba điểm hay bị hiểu sai
Crawl khác index như thế nào?
Crawl trả lời câu hỏi bot có vào đọc được trang không, còn index trả lời câu hỏi Google có muốn giữ trang đó trong kho kết quả không. Hai khả năng này thường được gọi là crawlability và indexability, và một trang có thể đạt cái đầu mà trượt cái sau. Trong Search Console, trạng thái Crawled - currently not indexed (Đã thu thập dữ liệu, hiện chưa được lập chỉ mục) chính là trường hợp đó, Googlebot đã tải trang nhưng Google chọn không lưu. Mình đã gặp đúng tình huống này ở solytix.app. Bản cũ của bài bạn đang đọc cùng năm bài cơ bản khác nằm trong nhóm này nhiều tháng, và theo mình nguyên nhân là các bài viết chung chung, chồng chủ đề lên nhau. Cách xử lý là gộp bài trùng, viết lại có dữ liệu riêng, chứ gửi lại URL nhiều lần không giúp gì. Danh sách đầy đủ các trạng thái và cách check index cho từng trang nằm ở bài riêng.
| Crawl (crawlability) | Index (indexability) | |
|---|---|---|
| Câu hỏi | Googlebot có tải được trang không | Google có lưu trang vào chỉ mục không |
| Bị chặn bởi | robots.txt, lỗi máy chủ 5xx, trang không có link nào trỏ tới | thẻ noindex, canonical trỏ sang URL khác, nội dung trùng hoặc ít giá trị |
| Xem ở đâu | Kiểm tra URL, báo cáo Số liệu thống kê thu thập dữ liệu | Báo cáo Lập chỉ mục trang trong Search Console |
| Cách sửa | Mở chặn, sửa máy chủ, thêm link nội bộ | Gỡ noindex, sửa canonical, gộp hoặc viết lại nội dung |
Robots.txt quyết định bot được vào đâu
Robots.txt là file văn bản đặt ở thư mục gốc của tên miền, ví dụ solytix.app/robots.txt, dùng để báo cho crawler phần nào được và không được tải. Google chỉ hiểu bốn trường là user-agent, allow, disallow và sitemap, còn crawl-delay mà nhiều bài hướng dẫn vẫn nhắc thì Googlebot bỏ qua. Ảnh dưới là robots.txt thật của Shopee, chặn giỏ hàng, trang thanh toán, trang tài khoản và rất nhiều biến thể của trang tìm kiếm, vì đó là những URL không có giá trị khi hiện trên Google mà lại sinh ra vô hạn. Có ba điều cần nhớ khi sửa file này:
- Disallow không đồng nghĩa với gỡ khỏi Google. Google cho biết URL bị chặn vẫn có thể xuất hiện trên kết quả nếu có link trỏ tới, chỉ là không có nội dung mô tả.
- Không kết hợp Disallow với noindex. Googlebot phải tải được trang mới đọc được thẻ noindex, nên chặn trong robots.txt sẽ khiến noindex vô tác dụng.
- Lỗi của chính file robots.txt cũng ảnh hưởng. Nếu file trả lỗi 4xx, Google coi như site không có robots.txt và crawl mọi thứ. Nếu trả lỗi 5xx, Google tạm dừng crawl cả site trong 12 giờ đầu rồi dùng bản đã lưu trước đó.
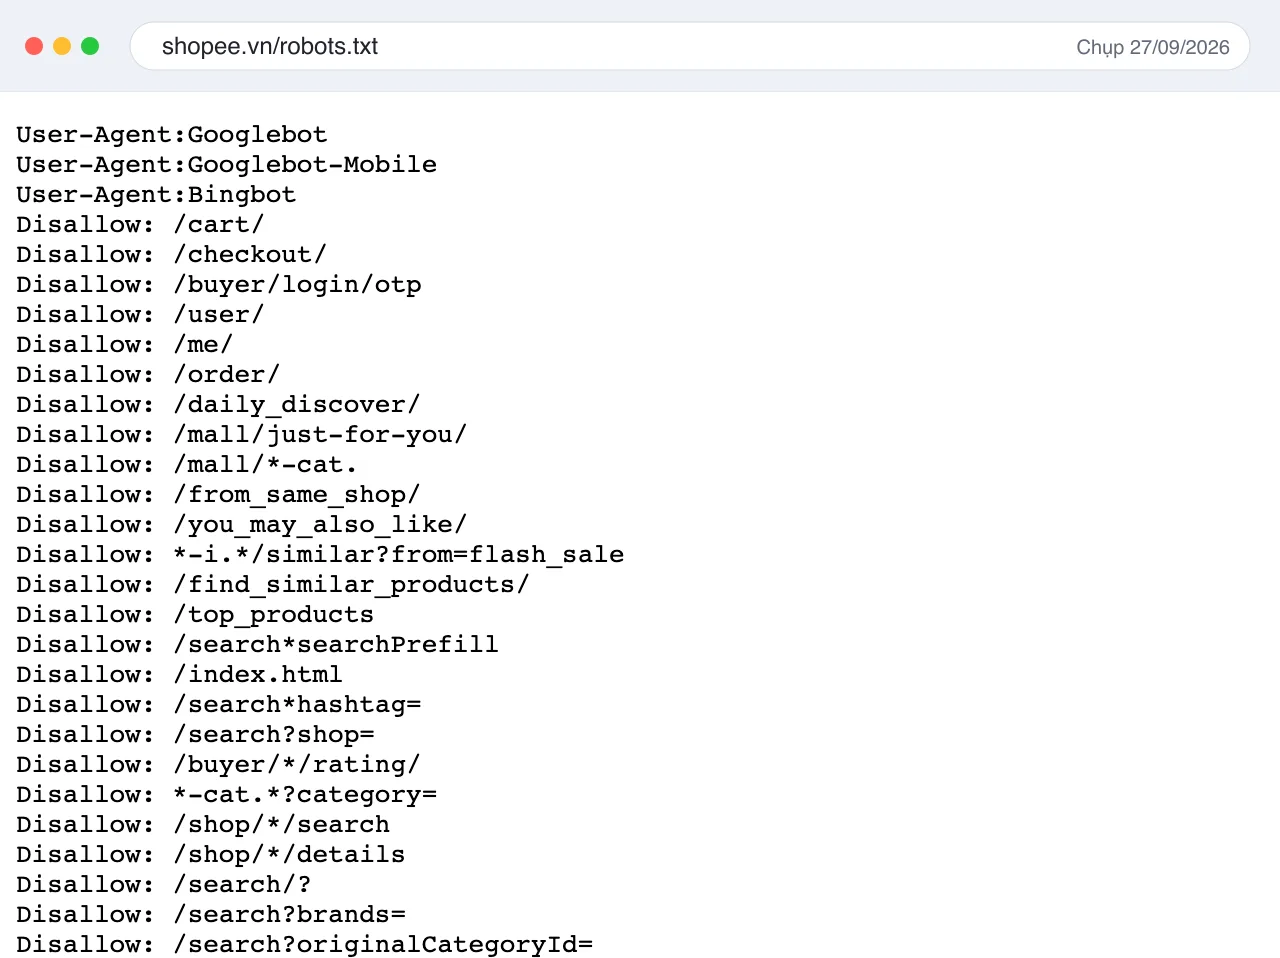 Robots.txt thật của Shopee chụp ngày 27/09/2026, chặn Googlebot và Bingbot vào giỏ hàng, trang thanh toán, trang tài khoản và các biến thể của trang tìm kiếm
Crawler của AI khác Googlebot ra sao?
Ngoài Googlebot, website còn được nhiều crawler của các công ty AI ghé thăm để lấy dữ liệu huấn luyện hoặc trả lời câu hỏi, và bạn chặn hay cho phép từng loại bằng chính robots.txt. Robots.txt của VnExpress trong ảnh dưới là ví dụ rõ, trang cho mọi bot tìm kiếm vào nhưng chặn toàn bộ GPTBot, ClaudeBot, Google-Extended, CCBot và nhiều crawler AI khác. Google-Extended đáng chú ý nhất vì dễ hiểu nhầm. Theo Google, chặn token này chỉ ngăn dữ liệu được dùng cho các mô hình Gemini, không ảnh hưởng tới việc trang xuất hiện hay xếp hạng trên Google Search. Lựa chọn ở đây là một đánh đổi thật sự. Báo lớn có lý do bảo vệ nội dung, còn một doanh nghiệp muốn được ChatGPT hay Gemini nhắc tên khi khách hỏi thì chặn crawler AI là tự rút khỏi cuộc chơi đó. Ngoài robots.txt, nhiều website còn tạo thêm file llms.txt dành cho mô hình AI, cách làm và giới hạn của file này có trong bài llms.txt là gì.
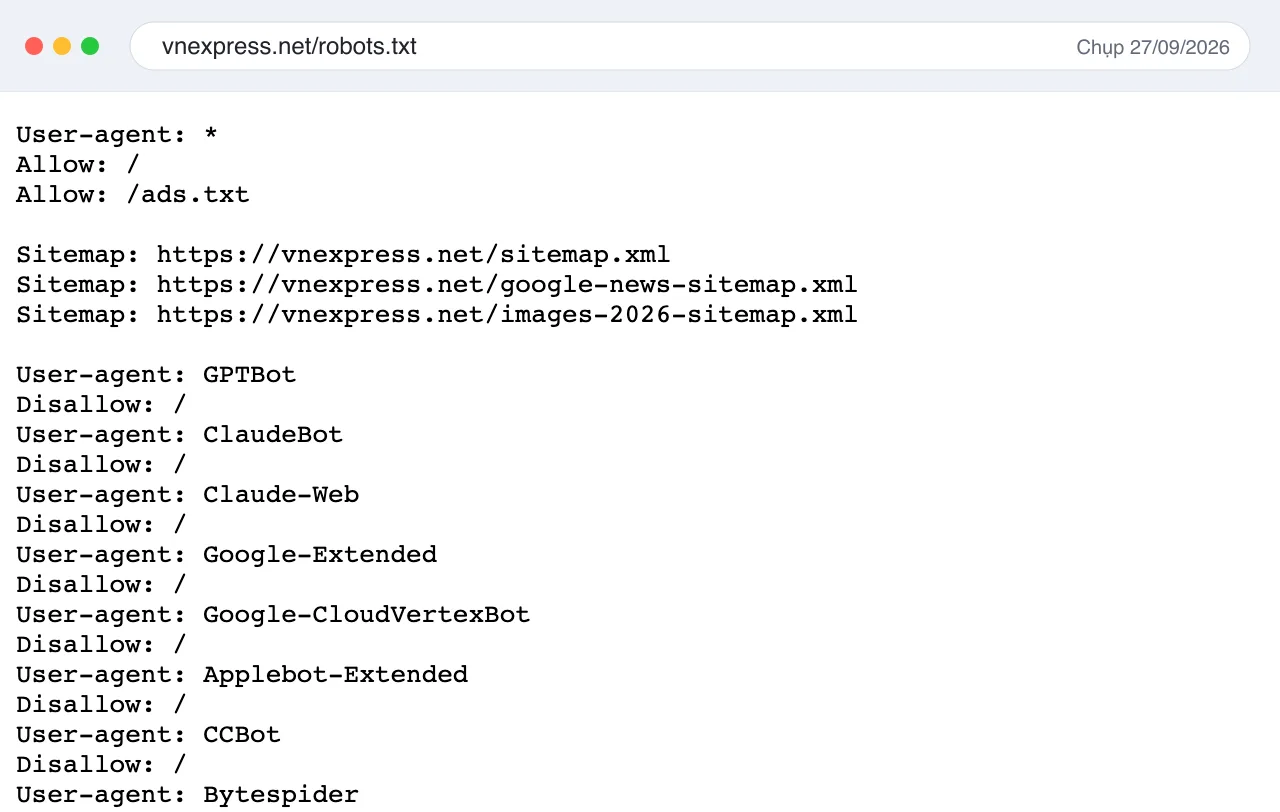 Robots.txt thật của VnExpress chụp ngày 27/09/2026, cho mọi bot tìm kiếm truy cập và khai báo ba sitemap, nhưng chặn GPTBot, ClaudeBot, Google-Extended, CCBot và nhiều crawler AI khác
Crawl budget là gì và website của bạn có cần lo không?
Crawl budget là tập hợp URL mà Google có thể và muốn crawl trên site của bạn, được quyết định bởi hai yếu tố. Giới hạn khả năng crawl phụ thuộc vào việc máy chủ chịu tải tốt đến đâu, máy chủ phản hồi chậm hoặc trả lỗi thì Googlebot tự giảm tốc. Nhu cầu crawl phụ thuộc vào độ lớn, tần suất cập nhật, chất lượng và mức độ liên quan của trang so với các site khác. Google nói thẳng rằng hướng dẫn tối ưu crawl budget dành cho site trên 1 triệu trang cập nhật hằng tuần, hoặc trên 10.000 trang cập nhật hằng ngày. Nếu trang mới của bạn được crawl ngay trong ngày đăng, bạn không cần bận tâm. Với site thương mại điện tử có bộ lọc sản phẩm thì khác, vì bộ lọc màu sắc, kích cỡ, giá sinh ra hàng triệu URL gần như trùng nhau. Khi đó các nguồn lãng phí thường gặp là URL tham số lọc và sắp xếp, chuỗi chuyển hướng nhiều tầng, trang lỗi 404 giả trả về mã 200, và trang dùng noindex thay vì chặn hẳn. Google lưu ý noindex vẫn tốn lượt crawl vì bot phải tải trang mới thấy thẻ. Với site nhỏ, việc đáng làm hơn là giữ cấu trúc website phẳng để trang quan trọng chỉ cách trang chủ vài cú nhấp.
Cách kiểm tra Google đã crawl trang của bạn chưa
Ba cách dưới đây đi từ đơn giản tới chuyên sâu:
- Kiểm tra URL trong Search Console. Dán URL vào ô tìm kiếm trên cùng, mở phần Thu thập dữ liệu để xem lần crawl gần nhất, crawler nào đã tải, trang có bị robots.txt chặn không. Nút Kiểm tra URL đang hoạt động cho biết Googlebot tải và render bản hiện tại ra sao.
- Báo cáo Số liệu thống kê thu thập dữ liệu. Nằm trong Cài đặt của Search Console, cho thấy tổng số yêu cầu crawl, dung lượng tải, thời gian phản hồi trung bình và tỷ lệ mã phản hồi theo ngày. Google ghi rõ báo cáo này dành cho người dùng nâng cao với site hàng nghìn trang.
- Log máy chủ. Log ghi lại mọi lượt Googlebot gọi tới máy chủ, là nguồn chính xác nhất cho site lớn. Vì tên Googlebot hay bị giả mạo, cần xác minh bằng cách tra ngược DNS của địa chỉ IP hoặc so với dải IP Google công bố.
Một thói quen cũ nên bỏ là tìm công cụ Tham số URL trong Search Console để khai báo cách xử lý URL lọc. Google đã gỡ công cụ này từ năm 2022, việc đó giờ làm bằng robots.txt và thẻ canonical.
Crawl data khác gì crawl của Google?
Crawl data, hay crawl dữ liệu, thường chỉ việc tự viết chương trình tải hàng loạt trang để lấy thông tin như giá sản phẩm, đánh giá hay danh sách bài viết, còn gọi là scraping. Về kỹ thuật, hai việc giống nhau ở chỗ đều là bot tải trang. Khác biệt nằm ở mục đích và phạm vi. Googlebot crawl rộng để lập chỉ mục cho công cụ tìm kiếm và tuân theo robots.txt, còn scraping thường nhắm vào vài trường dữ liệu cụ thể trên một nhóm trang, bằng các thư viện như Scrapy, BeautifulSoup hay Playwright. Nếu tự crawl dữ liệu của site khác, nên đọc robots.txt và điều khoản của site đó, giới hạn tốc độ để không làm quá tải máy chủ, và cân nhắc quy định về dữ liệu cá nhân trước khi lưu thông tin người dùng.
Câu hỏi thường gặp về crawl
Googlebot là gì?
Googlebot là tên chung cho crawler của Google Search, gồm Googlebot Smartphone và Googlebot Desktop. Hai loại dùng chung một tên trong robots.txt nên không thể chặn riêng từng loại. Phần lớn website hiện được crawl bằng Googlebot Smartphone.
Làm sao để Google crawl trang mới nhanh hơn?
Đưa URL vào sitemap.xml, đặt link tới trang mới từ những trang Google đã crawl thường xuyên như trang chủ hoặc bài đang có traffic, rồi dùng Kiểm tra URL trong Search Console để yêu cầu lập chỉ mục. Không có cách trả phí để được crawl thường xuyên hơn.
Chặn trang bằng robots.txt có làm trang biến mất khỏi Google không?
Không chắc chắn. Google cho biết URL bị chặn trong robots.txt vẫn có thể được lập chỉ mục nếu có link trỏ tới, chỉ là không có nội dung. Muốn gỡ trang khỏi kết quả tìm kiếm thì dùng thẻ noindex và để Googlebot crawl được trang đó.
Công cụ Tham số URL trong Search Console còn dùng được không?
Không. Google đã gỡ công cụ Tham số URL khỏi Search Console từ năm 2022. Muốn Googlebot bỏ qua các URL có tham số lọc hoặc sắp xếp, hãy chặn chúng trong robots.txt hoặc dùng thẻ canonical trỏ về URL chính.
Trước khi sửa robots.txt hay xin crawl lại
Ở solytix.app, mọi trang blog không được Google hiển thị đều đã được crawl bình thường, vấn đề nằm ở bước index. Vì vậy trước khi sửa robots.txt hay gửi URL lần thứ mười, hãy mở Kiểm tra URL để xem trang đang kẹt ở bước nào. Nếu trang đã được crawl mà vẫn không vào chỉ mục, câu hỏi đúng là trang này có gì mà mười kết quả đang đứng top chưa có. Solytix đồng bộ Search Console mỗi ngày và báo những trang đang mất lượt hiển thị để bạn biết nên xử lý trang nào trước, dùng thử miễn phí 30 ngày.
Trần Hoàng Sơn
Product Manager · SEO AutomationProduct Manager tại Solytix, hơn 4 năm làm product và SEO cho B2B SaaS tại thị trường Nhật Bản. Trên blog, Sơn viết về search intent và tự động hóa quy trình SEO bằng AI, ưu tiên case thật và cách làm áp dụng được ngay.